Kingdom
Pseudomonadati
Phylum
Pseudomonadota
Class
Gammaproteobacteria
Order
Pseudomonadales
Family
Pseudomonadaceae
Genus
Pseudomonas
Description
Taxonomy
| Kingdom | Pseudomonadati |
|---|---|
| Phylum | Pseudomonadota |
| Class | Gammaproteobacteria |
| Order | Pseudomonadales |
| Family | Pseudomonadaceae |
| Genus | Pseudomonas |
| Species | Pseudomonas sp. SWI36 |
| Strain | No strain |
Profile
| Physiology | |
|---|---|
| Gram staining properties | Not Available |
| Shape | Not Available |
| Mobility | Not Available |
| Flagellar presence | Not Available |
| Number of membranes | Not Available |
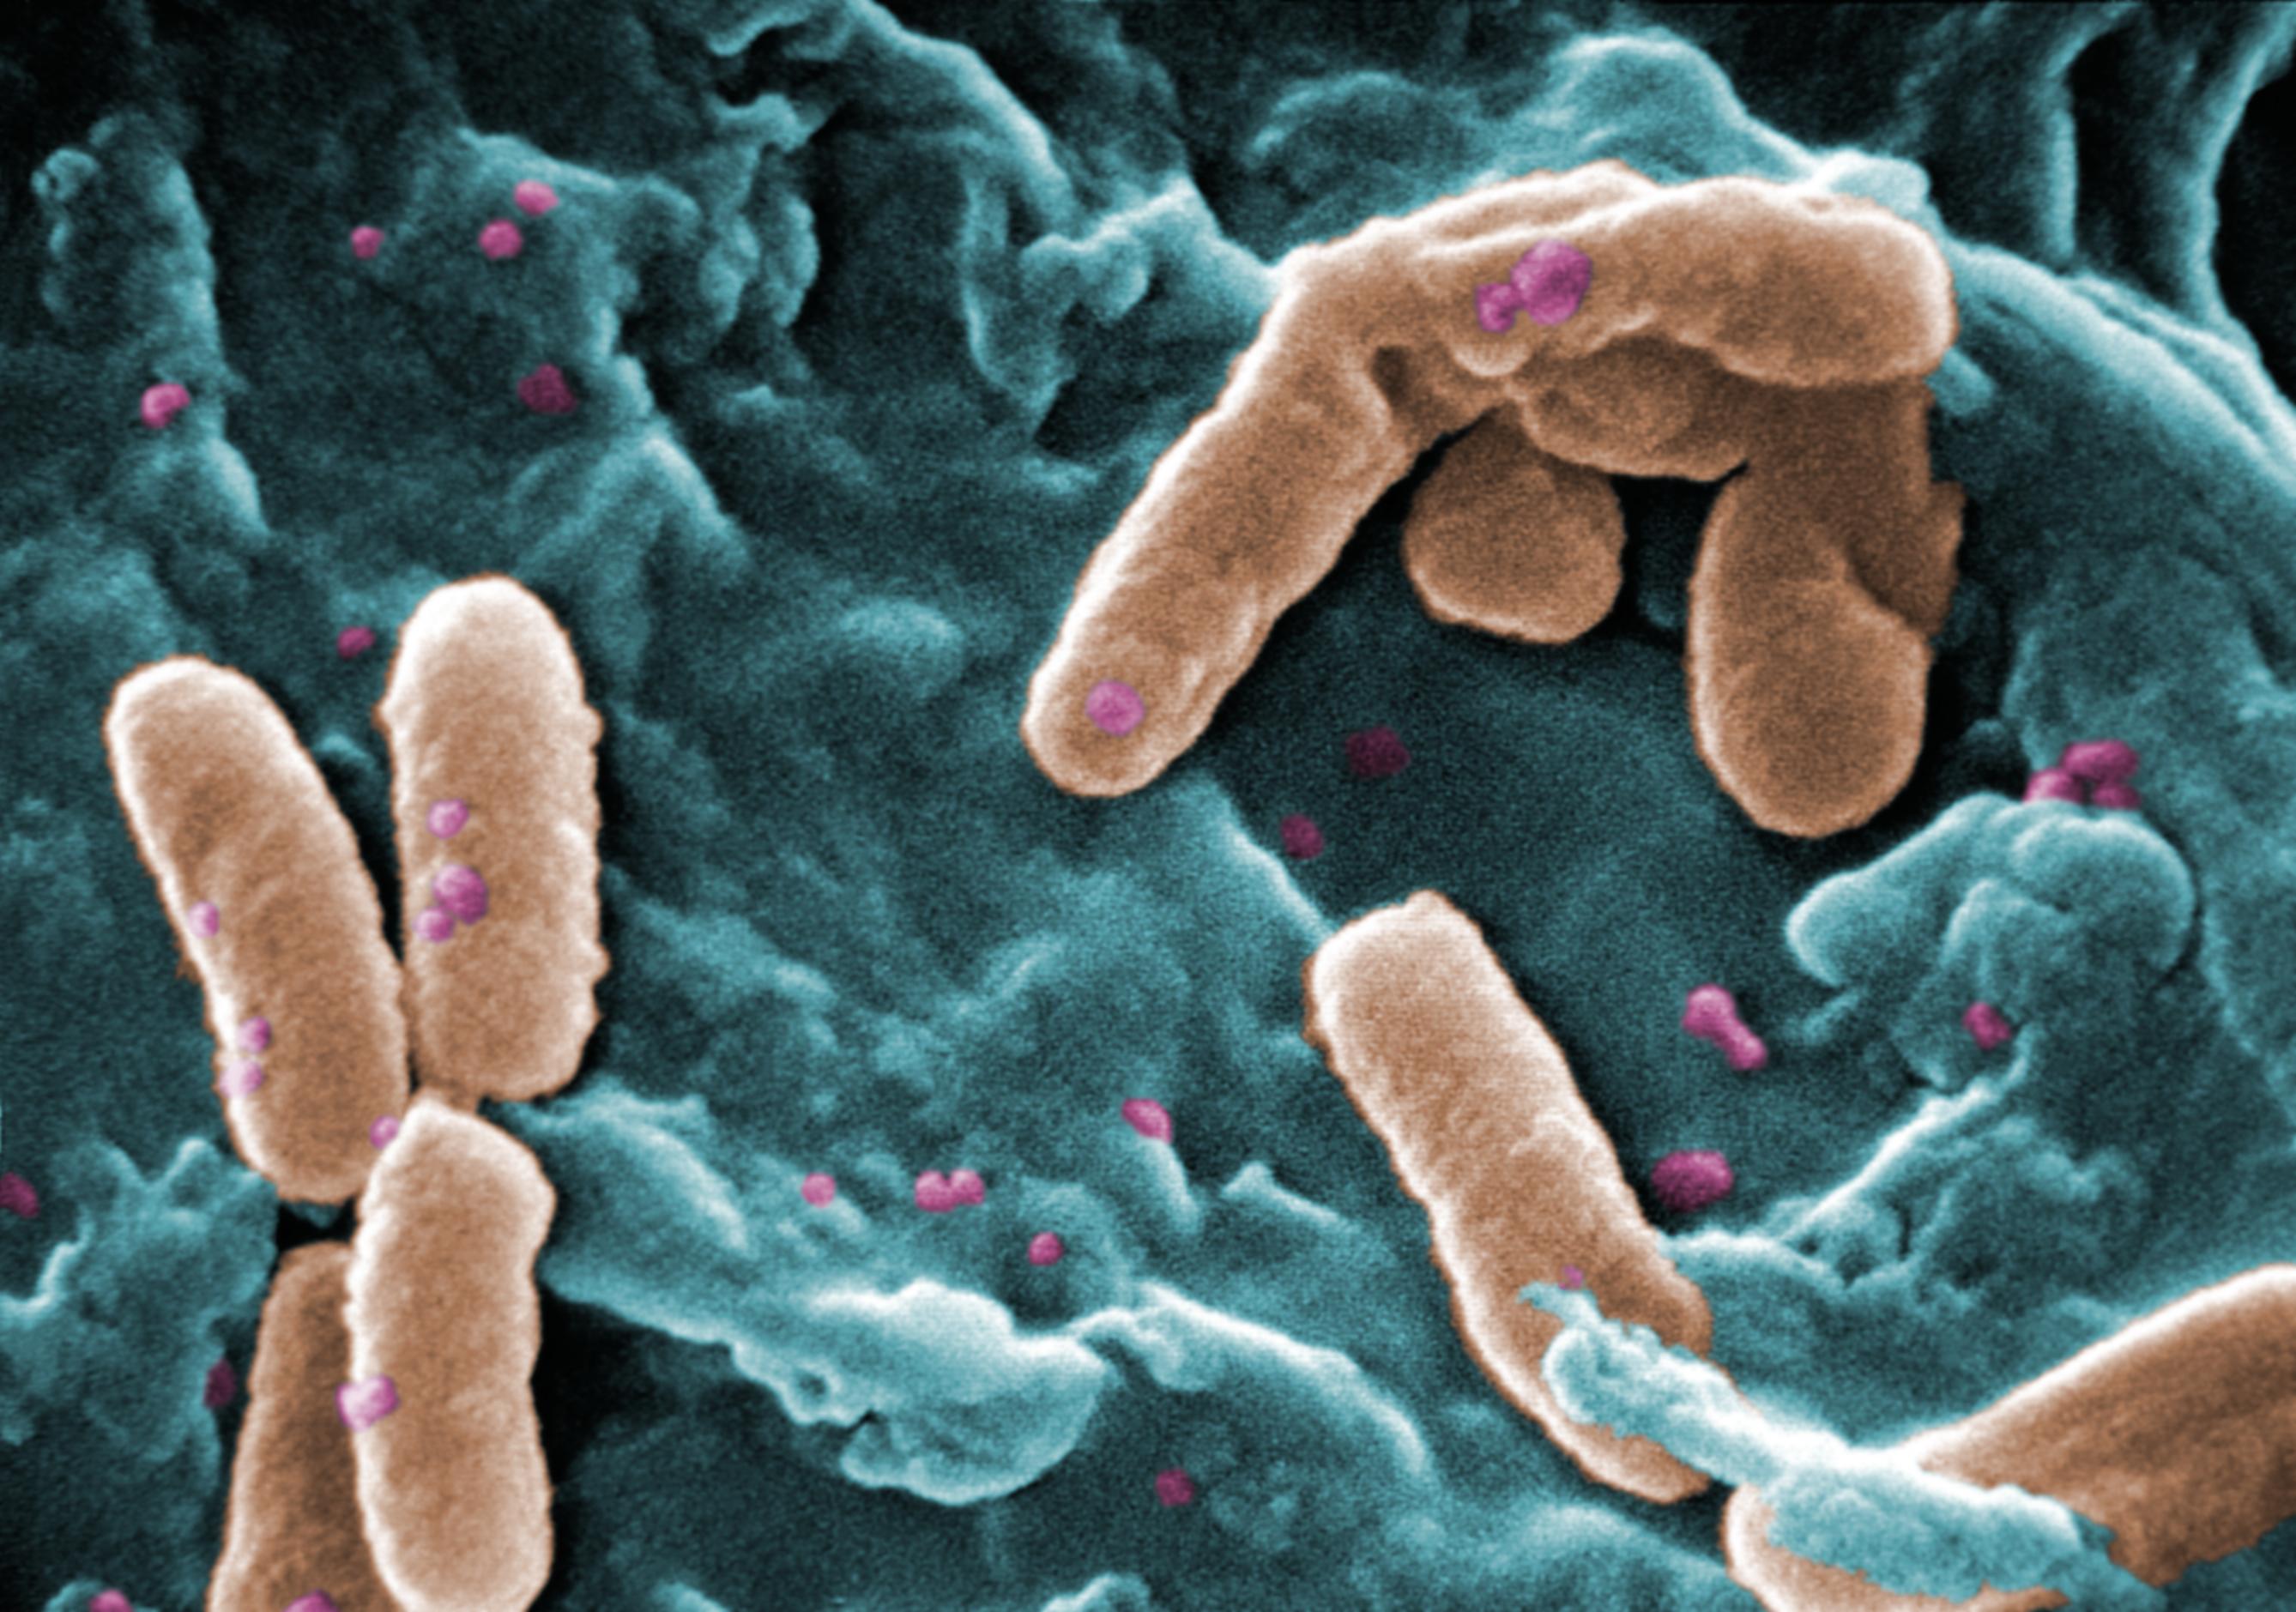
Image source: Wikipedia/Wikimedia
| Ecology, Host, and Life Cycle | |
|---|---|
| Oxygen requirements | Not Available |
| Optimal temperature | Not Available |
| Temperature range | Not Available |
| Habitat | Not Available |
| Biotic relationship | Not Available |
| Host(s) | Not Available |
| Cell arrangement | Not Available |
| Sporulation | Not Available |
| Energy source | Not Available |
| Pathogenicity | Not Available |
Gene Summary
Adenine Count
1175403 bp
Thymine Count
1180188 bp
Guanine Count
1908623 bp
Cytosine Count
1908042 bp
Genome Length
6172256 bp
Protein-coding Genes
5458 genes
Non-Coding Genes
167 genes
# of Chromosomes/Plasmids
1
Genes
| Name | Locus Tag | UniProt ID | Strand Orientation | Gene Start/End | Protein Molecular Weight |
|---|---|---|---|---|---|
| putative quinol monooxygenase | C4Q27_RS19975 | Not Available | Negative | 4168503 - 4168790 | 10743.6 |
| sdr family nad(p)-dependent oxidoreductase | C4Q27_RS19980 | Not Available | Negative | 4168822 - 4169586 | 26400.0 |
| lysr family transcriptional regulator | C4Q27_RS19985 | Not Available | Positive | 4169884 - 4170789 | 32613.6 |
| helix-turn-helix domain-containing protein | C4Q27_RS19990 | Not Available | Negative | 4171100 - 4172005 | 33846.6 |
| atu4866 domain-containing protein | C4Q27_RS19995 | Not Available | Negative | 4172218 - 4172472 | 9661.18 |
| sdr family oxidoreductase | C4Q27_RS20000 | Not Available | Negative | 4172502 - 4173239 | 25910.3 |
| nadp-dependent oxidoreductase | C4Q27_RS20005 | Not Available | Positive | 4173751 - 4174674 | 32286.7 |
| hypothetical protein | C4Q27_RS20010 | Not Available | Positive | 4175022 - 4175402 | 13801.9 |
| arac family transcriptional regulator | C4Q27_RS20015 | Not Available | Positive | 4175538 - 4176446 | 34193.2 |
| nadph-dependent 2,4-dienoyl-coa reductase | C4Q27_RS20020 | Not Available | Positive | 4176710 - 4178746 | 72358.9 |
Pathways
0 pathways
No pathways found
No metabolic pathways have been associated with this bacterium yet.
Health Effects
No health effects information available for this bacterium.


